

做到第 25 天時,我突然發現一件有點尷尬的事。
Visual Learning Lab 已經有 Source Atlas、Learning World、Universal Learning World Compiler、Direct Manipulation、Grounded Semantic Twin,也累積了幾百個自動化測試。但如果今天有一個完全沒看過前 25 篇文章的人打開專案,他可能還是會問:
所以這東西到底厲害在哪?
如果我要花十分鐘解釋架構、再告訴他哪裡要按、為什麼這個畫面和那個畫面其實是同一個 semantic state,那問題就不是評審看不懂,而是產品還沒有把自己的核心價值講清楚。
所以 Day 26 我決定先不加新功能。
今天只有一個目標:
把前 25 天做的東西,收斂成一條大約 90 秒就能親自驗證的 Golden Path。
如果只列目前功能,其實已經很多:
但這種列表其實很危險。
因為它很容易看起來像「我每天加了一個功能」。
我現在真正想證明的是另一件事:
真實教材
    ↓
Semantic Understanding
    ↓
Source Grounding
    ↓
Stable Semantic Entity
    ↓
Interactive Representation
    ↓
Direct Manipulation
    ↓
Canonical Shared State
    ↓
Multiple Synchronized Views
    ↓
Return to Original Source
這條鏈才是 Visual Learning Lab 到目前為止真正的核心。
前幾天為了測試 runtime,我留下了不少工程介面,例如鍵盤參數 fallback、時間 fallback、3D / static fallback、Exploration Recording、Replay、record counter 等。
它們不是沒用,但放在一般使用者面前,整個 Explore 頁面很像工程控制台。
所以 Day 26 第一件事不是增加東西,而是刪東西。
我把這些 learner-facing controls 收掉,只留下真正會用到的 Play、Pause、Reset、baseline / comparison 等少量工具。
底層 runtime 和安全契約沒有因為 UI 被拿掉就刪除,只是不再讓它們跟主要學習物件搶注意力。
這次也重新調整了 Source 與 Explore 的資訊層級,希望使用者第一眼看到的是:
教材裡的東西,以及它能怎麼被探索。
而不是一排控制器。
這次沒有用自己為 renderer 量身打造的測試文字。
我拿 MIT OpenCourseWare Classical Mechanics Chapter 5 的拋體運動教材,走實際 production pipeline。
教材中有一張初速度向量分解圖:
Source Atlas 會把原始教材區域和系統裡已存在的 semantic entities 接起來。
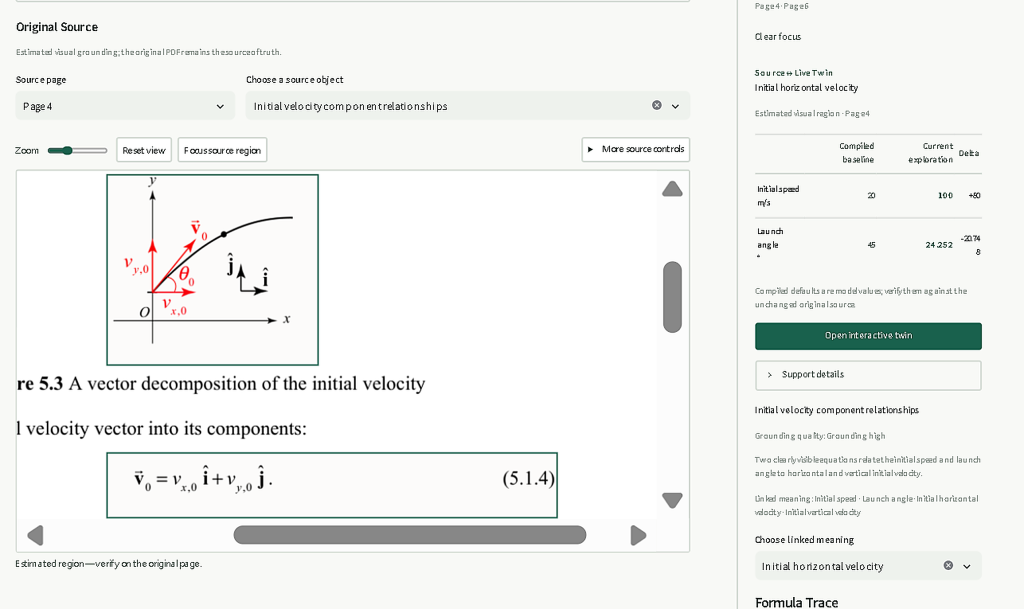
這裡有一個很重要的限制:
Source Atlas 並不是在「修改 PDF」。
PDF 還是原來的 PDF。
它只是建立:
source evidence
↔ semantic ID
之間的關係。
當我選到一個有互動 representation 的 semantic entity 時,右側會出現可以進入互動世界的入口。
目前工程名稱叫做:
Open interactive twin
它的底層概念就是 Grounded Semantic Twin。
這個名字其實連我自己實際驗收時都覺得有點抽象。
最簡單的解釋是:
教材裡那個不能動的概念,在互動世界裡的同一個 semantic object。
例如教材原始條件可能是:
Initial speed = 20 m/s
Launch angle = 45°
這些是教材內容,所以不能因為我拖動畫面就偷偷把原文改掉。
Interactive Twin 會另外保留:
Compiled baseline
20 m/s
45°

Current exploration
100 m/s
24.252°
也就是「教材說什麼」和「我現在探索到哪裡」是兩件不同的事情。
這是我目前很喜歡的一個設計。
因為互動教材很容易讓使用者忘記哪些數字來自來源、哪些是自己調出來的。
Visual Learning Lab 現在刻意把兩者拆開。
進入 Explore 之後,這次我不是去拉一個和畫面分離的 slider。
我直接抓住初速度向量的端點。
向量長度代表初速度,方向代表發射角。
拖動之後,系統把 gesture 轉成 semantic parameter update,再經過 validator 提交到 canonical state。
接著其他 representation 都從同一個 state 更新。
我實際把狀態拖到:
Initial speed ≈ 100 m/s
Launch angle ≈ 24.252°
這時一起更新的不是只有向量。
還包括:
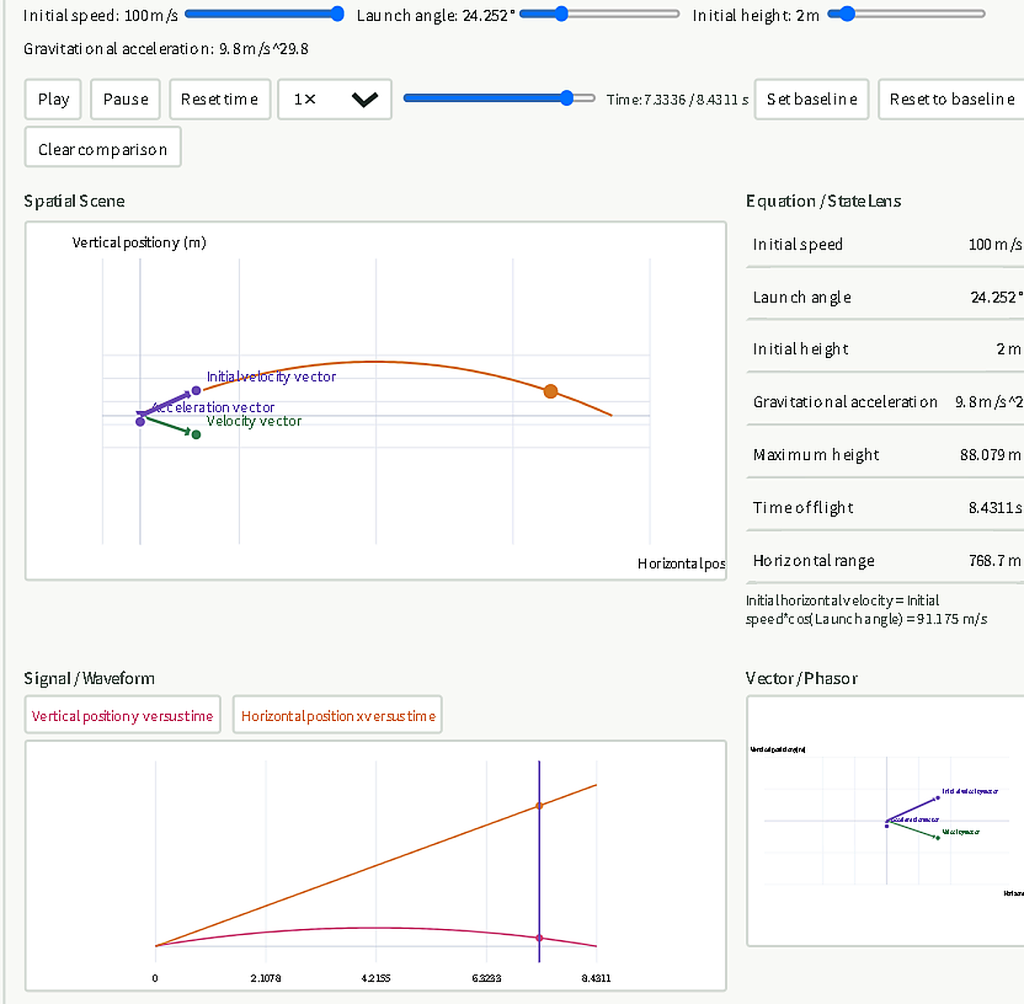
這也是我現在認為 Direct Manipulation 真正有價值的地方。
如果只是「拖一個球」,其實很容易做。
比較難的是:
拖動的那個東西,必須真的對應 semantic state,而且所有畫面都認同這次修改。
另外一個我一直很在意的點是 API。
如果每拖一次都重新問模型:
「請幫我計算現在的軌跡。」
那這個產品不只慢,也會變得非常昂貴,而且不同 request 之間還可能產生語意漂移。
所以現在 Learning World 編譯完成後:
drag
playback
state update
trajectory recomputation
derived values
view synchronization
source navigation
都是 local runtime。
這次 Golden Path 的 direct manipulation 階段:
API request delta = 0。
模型負責理解與提出結構,互動階段由受控 runtime 負責執行。
探索完之後,右側還保留:
Return to supporting source
按下去會回到當初這個 semantic entity 所對應的教材區域。
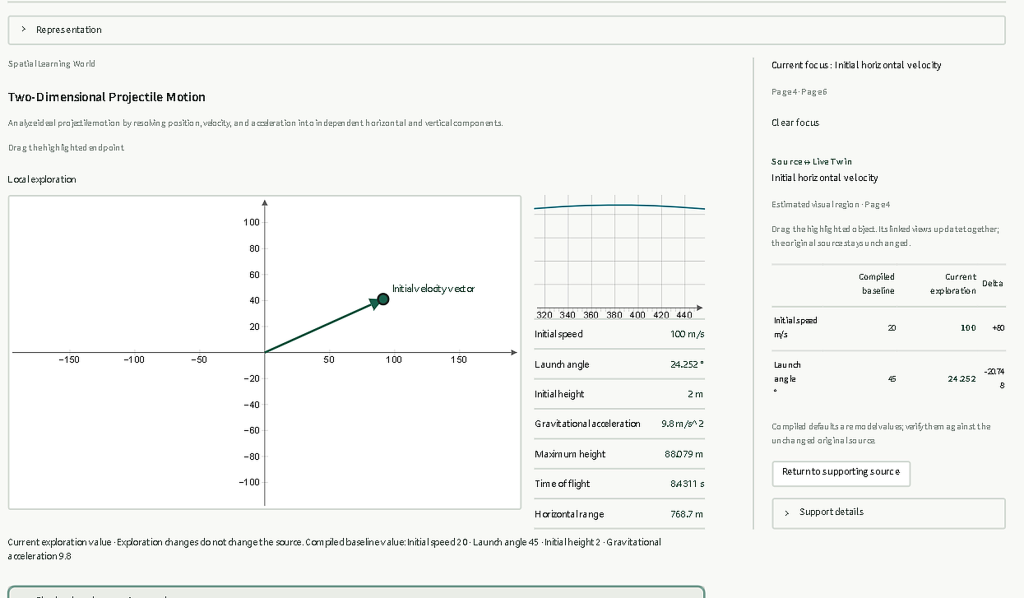
這條 roundtrip 對我來說很重要。
因為最後它形成的是:
Source
→ Meaning
→ Interaction
→ State Change
→ Representation
→ Source
而不是:
PDF
→ AI 生一張新圖
→ 使用者不知道這張圖哪裡來的
Day 26 還刻意留了一個 control case。
例如 x_position 這種 derived quantity。
如果你看到:
x = v0 cos(theta) t
然後直接拖 x,系統到底應該修改:
答案並不唯一。
如果 runtime 沒有合法 inverse mapping,我不希望系統為了看起來很互動,硬生出一個把手。
所以不可操作的 semantic entity 仍然可以:
focus
source grounding
formula trace
related representation
但不一定有 draggable handle。
這是我現在對「互動」的一個重要限制:
能動不代表比較好,知道什麼時候不能亂動反而更重要。
自動化測試可以確認很多事情,但今天實際操作時還是抓到了兩類問題。
第一個是 UX。
我自己第一次照 Golden Path 操作時,其實也一度在找:
到底哪個才是「分身」?
功能存在不代表功能容易被找到。
這次 Source 頁面已經比之前清楚很多,但 Interactive Twin 仍然是一個偏工程術語。
這件事目前先保留成產品限制,而不是假裝第一次使用者一定懂。
第二個問題更重要:validator。
中文拋體教材有一次產生的 Learning World declaration 因為 height = 0 被拒絕。
Terminal 顯示:
Positive semantic parameter has a non-positive range: height
原本的 parameter policy 把 length 和一些必須嚴格大於零的 quantity 放在同一組,因此 ground-level initial height = 0 也被當成非法。
更麻煩的是,後續離線 audit 又證明:
如果粗暴地把所有 length 改成可以等於 0,wavelength = 0 和 radius = 0 也可能被放過。
這讓我重新確認了一件事:
Safety 不是「越嚴越好」,也不是「讓 Demo 通過就好」。
真正需要的是 deterministic semantic contract。
物理量的 dimension/type,和它允許的數值 domain,其實是兩件不同的事情。
這個問題也會繼續列入後續 reliability / security hardening,而不是靠一直重新生成,直到碰巧得到一份 validator 喜歡的 JSON。
Day 26 最後的成果不是一個新的 renderer。
而是一條現在真的可以操作的 vertical slice:
真實教材
→ 找到來源
→ 找到語意
→ 進入互動 representation
→ 直接操作物件
→ 多視圖同步
→ 回到原始來源
更重要的是,這條路同時把幾個一直分散在前幾天的設計串起來:
這也是目前我最想讓評審看到的 Visual Learning Lab。
不是一個會把 PDF 摘要成幾個 bullet point 的聊天介面。
而是一個嘗試把教材裡的知識,編譯成「可以被操作、但仍然保留來源」的學習環境。
Day 26 開發過程中跑過一輪 437 tests 的完整 regression,當時 427 通過,另外 10 個失敗來自被移除的舊 UI control assertions;這些項目後續已用 focused tests 修正與重測。
在 parameter semantic 問題上,相關 focused suite 有 141 個測試通過。
但我不會把這些數字寫成:
「系統已經能正確理解任何教材。」
這些測試能證明的是 validator、state transition、interaction contract、request discipline 等工程行為。
它們不能證明每一份陌生 PDF 的語意都會被模型理解正確。
目前也還有幾個明確限制:
這些剛好就是剩下幾天要處理的東西。
Day 27 我不想再自己準備一份「很適合 Visual Learning Lab」的教材。
我要開始拿陌生教材攻擊它。
而且這次還會加入一個很現實的問題:
目前一直使用的模型,到底還是不是最適合這套 semantic compiler?
下一步我準備用同一批陌生教材,比較目前模型和更強模型在:
上的差異。
如果更強模型真的有用,就用數據決定換。
如果沒有,就不因為版本號比較新而換。
剩下四天,開始進入真正的壓力測試。


 iThome鐵人賽
 看影片追技術